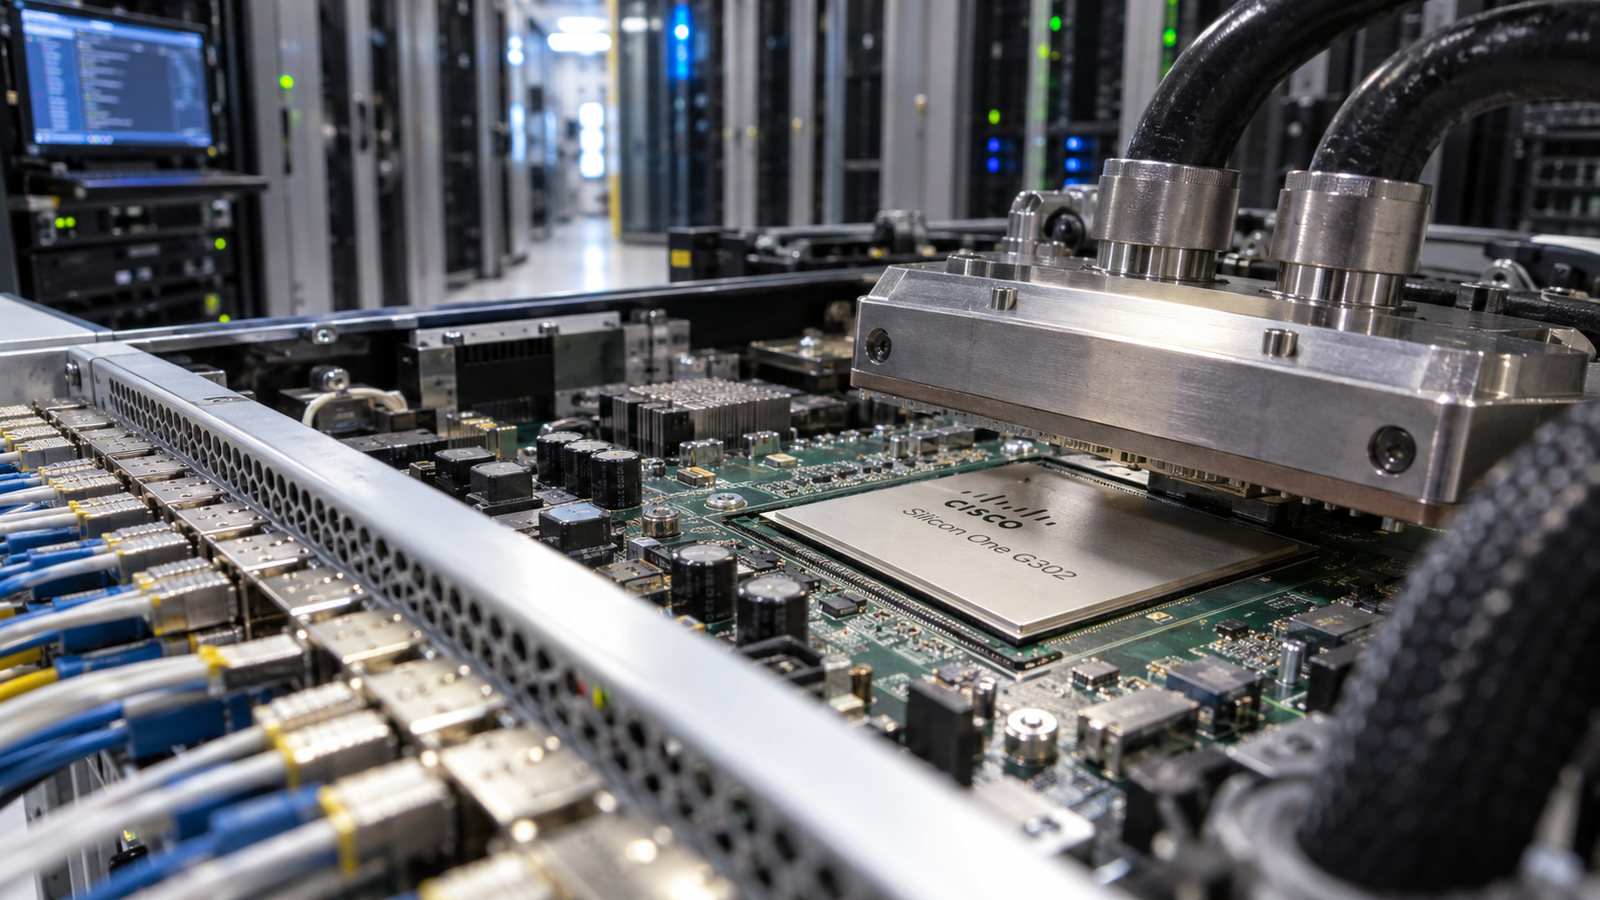
Cisco ha alzato il sipario su Silicon One G302 durante l'OCP Global Summit, l'evento dedicato all'open computing. Si tratta di un nuovo processore di switching progettato per rispondere alle esigenze sempre più pressanti delle reti che alimentano l'intelligenza artificiale. Con una capacità dichiarata di 51,2 Tbps, il chip si posiziona come una delle soluzioni più performanti per collegare cluster di GPU e sistemi di calcolo ad alte prestazioni.
Prestazioni e architettura
Il cuore di Silicon One G302 è pensato per gestire enormi volumi di traffico est-ovest, tipici dei carichi di lavoro AI distribuiti. La capacità di 51,2 Tbps consente di ridurre il numero di switch necessari, semplificando il cablaggio e abbattendo i costi operativi. Cisco sottolinea che il processore è ottimizzato per l'elaborazione a bassa latenza, un requisito cruciale quando migliaia di acceleratori devono scambiarsi dati in tempo reale per addestrare modelli di grandi dimensioni.
Impatto sulle infrastrutture AI
L'annuncio arriva in un momento in cui la domanda di potenza di calcolo per l'IA generativa è in forte crescita. I data center devono affrontare colli di bottiglia di rete che limitano l'efficienza delle GPU. Con Silicon One G302, Cisco intende offrire una piattaforma scalabile che supporti architetture spine-leaf e topologie avanzate, facilitando l'adozione di standard aperti come quelli promossi dall'OCP. Il chip è progettato per integrarsi con le soluzioni software di Cisco, garantendo visibilità e controllo centralizzati.
La mossa rafforza la posizione di Cisco nel mercato dei semiconduttori per networking, dove la concorrenza di Broadcom e Nvidia si fa agguerrita. Silicon One G302 non è solo un esercizio di stile: rappresenta un tassello concreto per costruire infrastrutture AI più efficienti, capaci di sostenere l'addestramento di modelli sempre più complessi senza strozzature. La disponibilità e i dettagli commerciali saranno comunicati nei prossimi mesi, ma l'orientamento è chiaro: le reti del futuro dovranno essere veloci quanto le GPU che servono.



