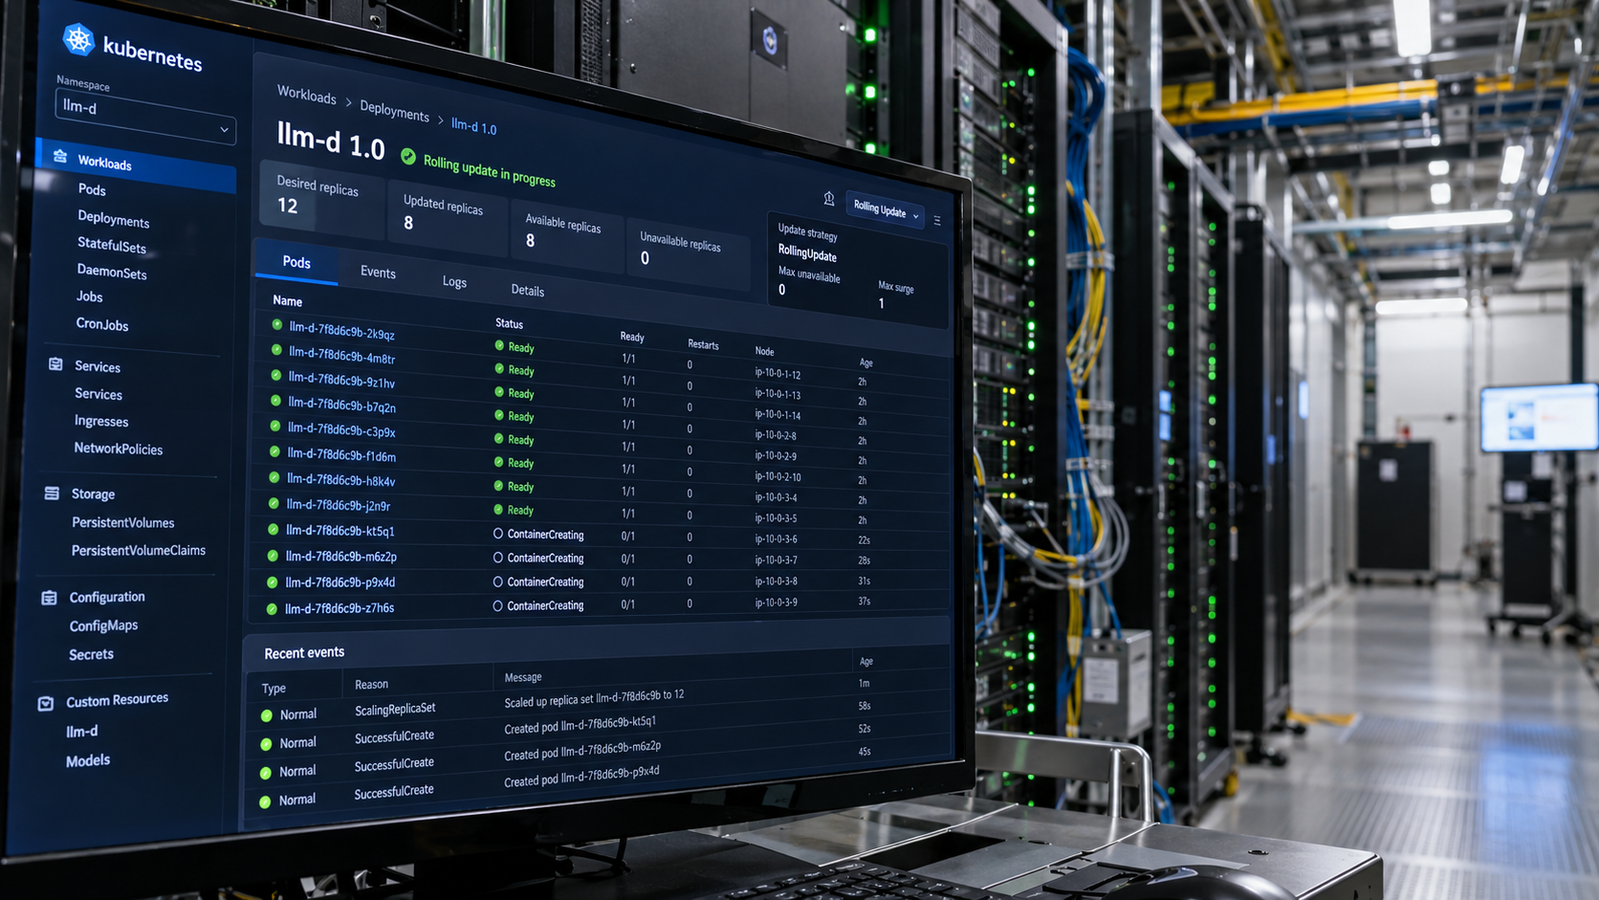
Alla PyTorch Conference North America, IBM ha svelato insieme ai contributori del progetto llm-d 1.0, la prima release stabile di un framework open source pensato per rivoluzionare il modo in cui i modelli di intelligenza artificiale vengono eseguiti. L'obiettivo è chiaro e ambizioso: mettere fine agli sprechi di potenza di calcolo che caratterizzano l'inferenza dei grandi modelli linguistici, un problema che pesa sempre di più sui costi operativi delle aziende.
Perché l'AI spreca risorse
Oggi l'inferenza dei modelli AI avviene spesso in modo inefficiente: le GPU restano inattive in attesa di richieste, oppure vengono sovraccaricate senza una reale necessità. llm-d 1.0 affronta il problema distribuendo il carico di lavoro su più nodi e sfruttando tecniche di orchestrazione intelligente. In pratica, il framework decide dinamicamente dove e come eseguire le richieste, riducendo i tempi morti e massimizzando l'utilizzo dell'hardware disponibile.
Un ecosistema aperto per l'inferenza
Il rilascio segna un passo importante per l'intero settore: essendo open source, llm-d può essere adottato e migliorato da qualsiasi sviluppatore o azienda, creando uno standard condiviso per l'inferenza distribuita. IBM punta così a democratizzare l'accesso a un'infrastruttura AI efficiente, riducendo la dipendenza da costose soluzioni proprietarie. La versione 1.0 introduce miglioramenti nella gestione della memoria, nel bilanciamento del carico e nella compatibilità con i principali framework di machine learning.
Con questo annuncio, IBM si posiziona come attore chiave nella corsa all'ottimizzazione dell'AI, un tema sempre più centrale man mano che i modelli crescono di dimensioni e le risorse energetiche diventano un vincolo concreto. Se adottato su larga scala, llm-d potrebbe ridurre sensibilmente l'impronta energetica dell'intelligenza artificiale, rendendo l'inferenza più sostenibile ed economica per tutti.



