Reflection ha svelato Beam, un nuovo modello di intelligenza artificiale sviluppato completamente da zero. A differenza di molti concorrenti che partono da pesi pre-addestrati, Beam è stato costruito internamente per eccellere in tre aree chiave: ragionamento complesso, programmazione e attività svolte tramite agenti autonomi. La notizia conferma la volontà dell'azienda di ritagliarsi uno spazio nel panorama dei modelli fondazionali, puntando su capacità avanzate e su un addestramento totalmente proprietario.
Perché servono 10.500 GPU
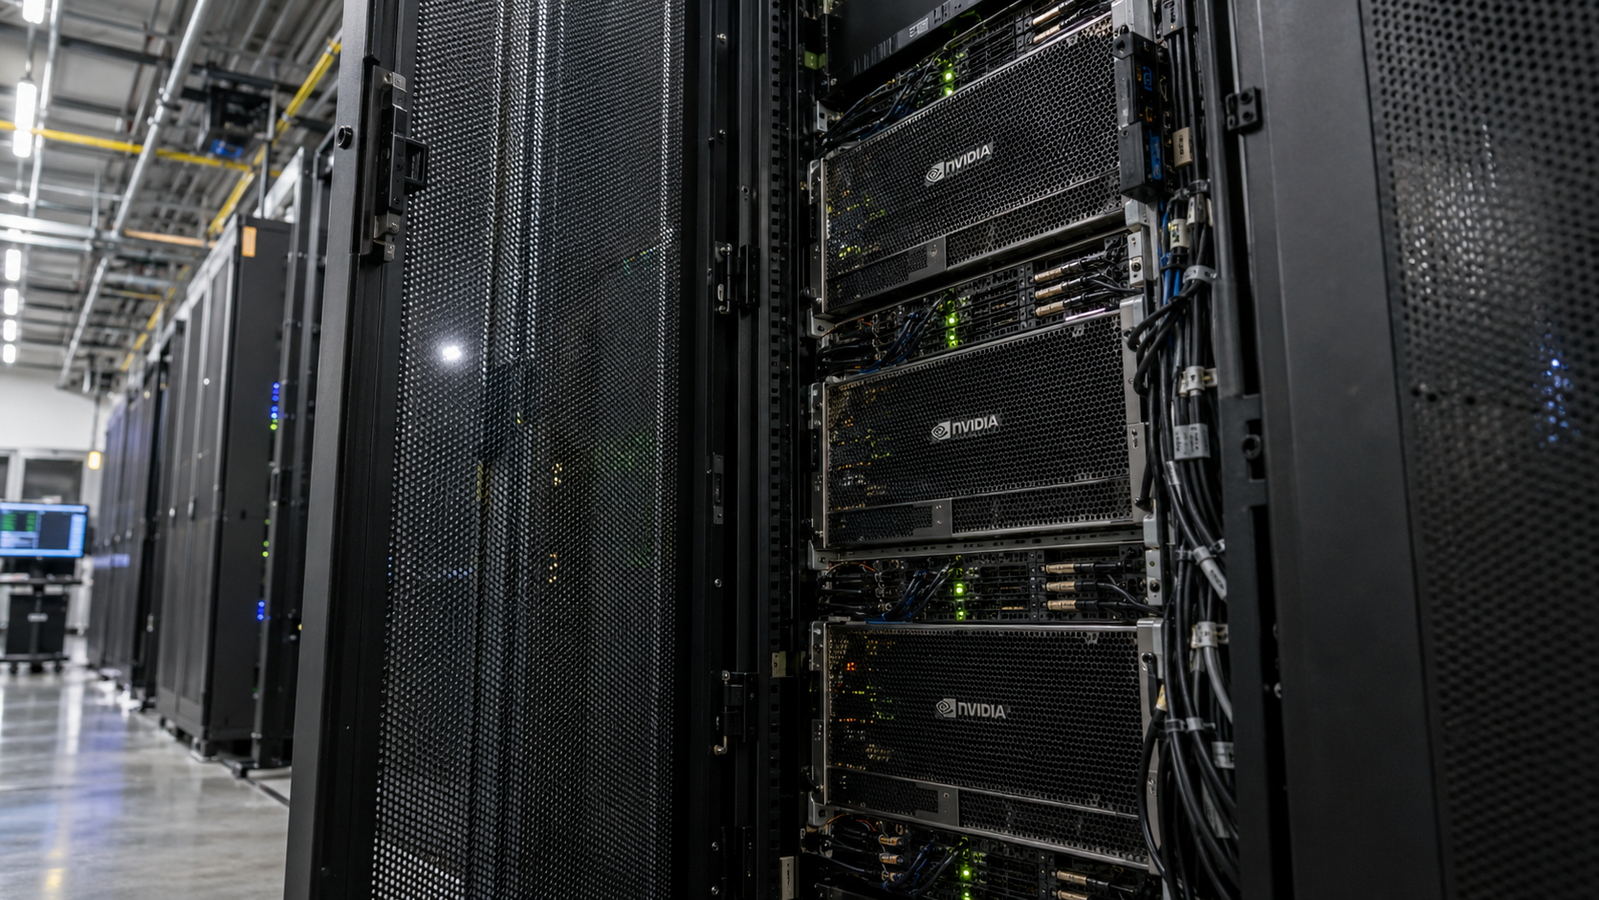
Il dato che ha fatto scalpore è l'impiego di 10.500 GPU per la fase di apprendimento. Si tratta di un numero enorme, ma non casuale. Addestrare un modello da zero richiede di elaborare miliardi di parametri e di far passare enormi quantità di dati attraverso la rete neurale. Ogni GPU lavora in parallelo per accelerare i calcoli, ma la coordinazione tra migliaia di unità è complessa e costosa. Reflection ha scelto questa strada per garantire prestazioni elevate su compiti che richiedono ragionamento articolato e generazione di codice affidabile, dove i modelli più piccoli o pre-addestrati faticano.
Impatto sul settore e prospettive
L'uso massiccio di GPU non è solo una questione di potenza di calcolo, ma anche di efficienza energetica e costi. Reflection punta a ottimizzare l'infrastruttura per ridurre i tempi di addestramento e migliorare la scalabilità. Questo approccio potrebbe dare a Beam un vantaggio competitivo in ambito enterprise, dove servono agenti capaci di operare in autonomia su task di programmazione e problem solving. La sfida ora è dimostrare che tanta potenza si traduca in risultati concreti e in un modello realmente superiore.
Con Beam, Reflection entra a pieno titolo nella corsa ai modelli di frontiera, ma la vera prova sarà l'adozione da parte degli sviluppatori e delle aziende. Se il modello manterrà le promesse, il numero di GPU potrebbe diventare uno standard per i futuri addestramenti da zero.



