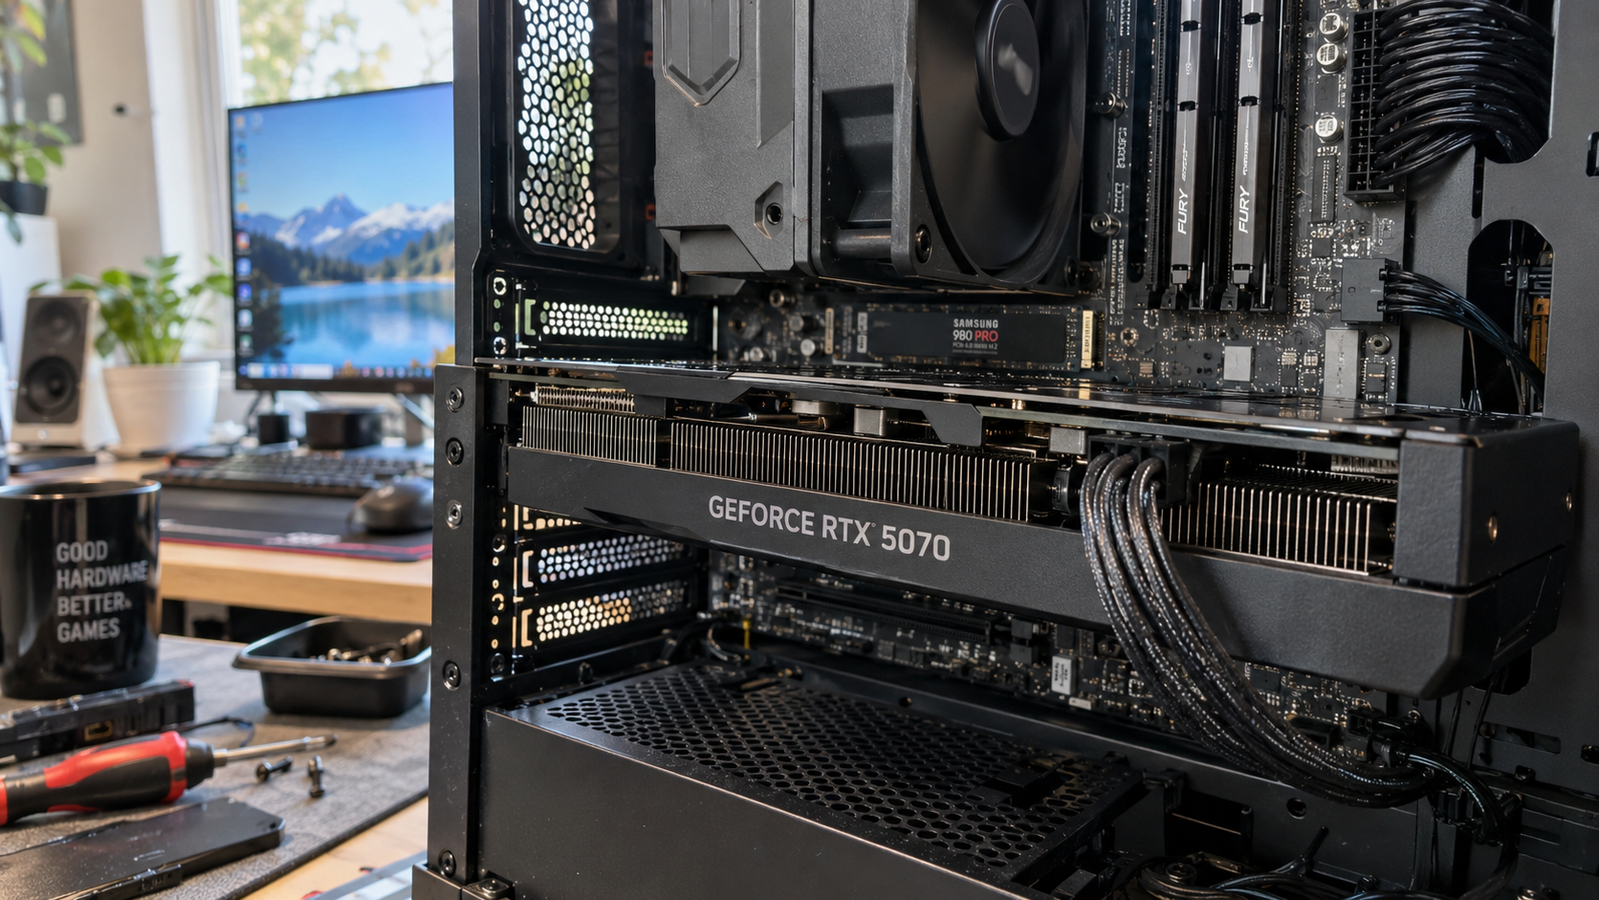
Eseguire un modello linguistico da 125 miliardi di parametri su una scheda video con appena 12 GB di VRAM? Fino a poco tempo fa sarebbe sembrata pura fantascienza. Eppure, grazie al progetto Strata sviluppato da Niko1221, tutto ciò è ora possibile su una RTX 5070. Il segreto sta in un'architettura software che distribuisce dinamicamente i pesi del modello tra la memoria video e la RAM di sistema, aggirando i limiti imposti dalla dotazione hardware.
Come funziona Strata
Il cuore di Strata è un sistema di offloading intelligente: i layer del modello Qwen3.8-Flash-Next vengono suddivisi tra la VRAM della GPU e la memoria centrale del PC. La RTX 5070 elabora i calcoli più pesanti, mentre le porzioni meno critiche restano in RAM, pronte per essere richiamate all'occorrenza. Questo approccio riduce drasticamente il fabbisogno di memoria video, senza compromettere in modo significativo le prestazioni complessive. Il risultato è un modello di grandi dimensioni che gira localmente, con una latenza accettabile e senza dipendere da servizi cloud.
Perché è una svolta per l'IA locale
La vera novità non è solo tecnica, ma democratica: Strata abbassa l'asticella per chi vuole sperimentare con l'intelligenza artificiale di fascia alta senza dover acquistare GPU da migliaia di euro. Un utente con una scheda di fascia media può ora testare modelli che fino a ieri richiedevano hardware professionale. Il progetto è open source e la community sta già contribuendo con ottimizzazioni e configurazioni alternative. Se il trend proseguirà, il confine tra ciò che è possibile eseguire in locale e ciò che richiede il cloud diventerà sempre più sottile, aprendo scenari inediti per sviluppatori, ricercatori e appassionati.