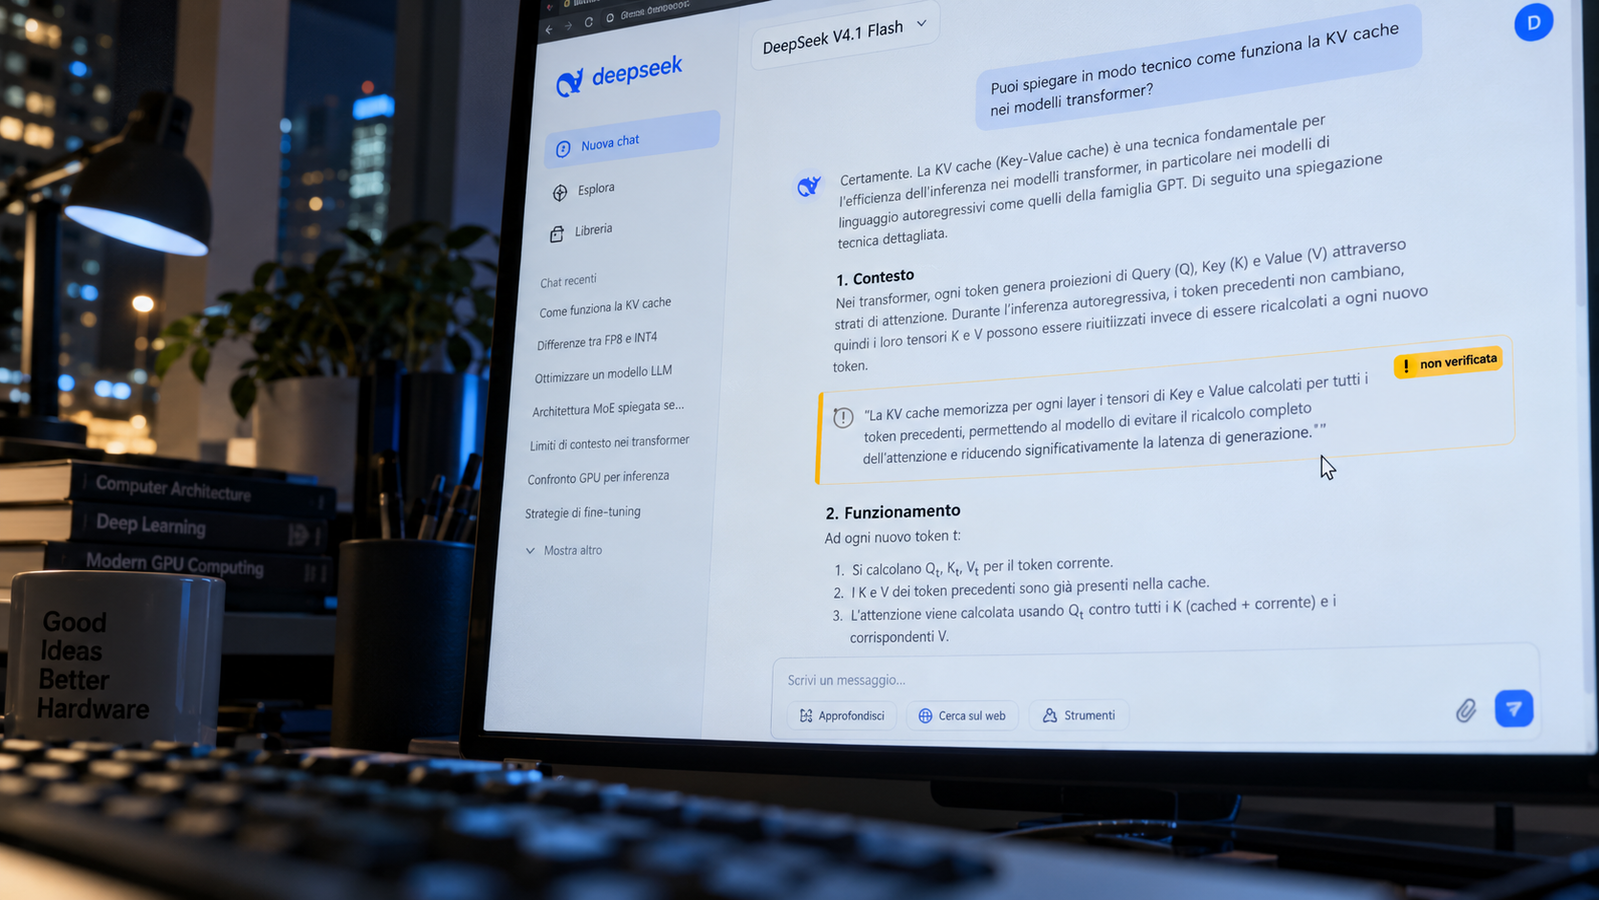
DeepSeek torna a far parlare di sé con DeepSeek V4.1 Flash, una revisione del proprio modello che punta a ottimizzare l'efficienza senza rinunciare alle prestazioni. La novità principale riguarda la gestione della memoria: la nuova versione riduce sensibilmente la quantità di RAM necessaria durante l'esecuzione, un aspetto cruciale per chiunque voglia eseguire il modello su hardware meno potente o in ambienti con risorse limitate. L'obiettivo dichiarato è chiaro: contenere i costi delle attività affidate all'intelligenza artificiale, rendendo l'uso del modello più sostenibile sia per gli sviluppatori indipendenti sia per le aziende.
Efficienza migliorata, ma non tutto fila liscio
Nei test condotti finora, V4.1 Flash ha mostrato risultati incoraggianti sul fronte della velocità e del consumo di risorse, confermando la direzione intrapresa dal team di sviluppo. Tuttavia, è emerso un problema che riporta alla memoria vecchie criticità già osservate nelle versioni precedenti: alcuni limiti di accuratezza e coerenza nelle risposte continuano a manifestarsi in scenari complessi. Non si tratta di un difetto bloccante, ma di un'incongruenza che gli utenti più esigenti potrebbero notare, soprattutto in attività che richiedono ragionamenti articolati o risposte precise su temi tecnici.
Un aggiornamento che guarda al futuro
Il rilascio di DeepSeek V4.1 Flash conferma la strategia dell'azienda cinese: puntare sull'efficienza computazionale per competere in un mercato sempre più affollato, dove i modelli open source e le alternative a basso costo stanno guadagnando terreno. La riduzione della memoria necessaria rappresenta un vantaggio concreto per chi distribuisce applicazioni basate su AI, ma il persistere di alcune debolezze suggerisce che il lavoro di rifinitura non è ancora concluso. Gli sviluppatori sono ora chiamati a valutare se i benefici in termini di risparmio compensino le imperfezioni residue, in attesa di futuri aggiornamenti che potrebbero colmare definitivamente il divario.



